華碩發表 ASUS UGen Intel Arc Pro B70 32GB 推論加速卡,內建 32GB GDDR6 ECC 記憶體,可支援多數 27B 參數以下的模型,並可透過雙卡 64GB 或多卡 128GB 擴充,支援 Ollama、llama.cpp、PyTorch XPU 等 AI 軟體堆疊。
本文為華碩提供之新聞稿。更多新聞稿請見 NewsRoom。
(10 月 28 日,台北訊) 隨著大型語言模型(LLM)與多代理工作流程加速從雲端走向工作站,華碩直擊市場最迫切痛點,發表全新 ASUS UGen Intel® Arc™ Pro B70 32GB 推論加速卡,以親民實惠價格提供 32GB GDDR6 ECC 超大容量記憶體,再加上專為推論優化的硬體架構,絕對是企業執行地端代理式 AI(Agentic AI)時不容錯過的選擇!
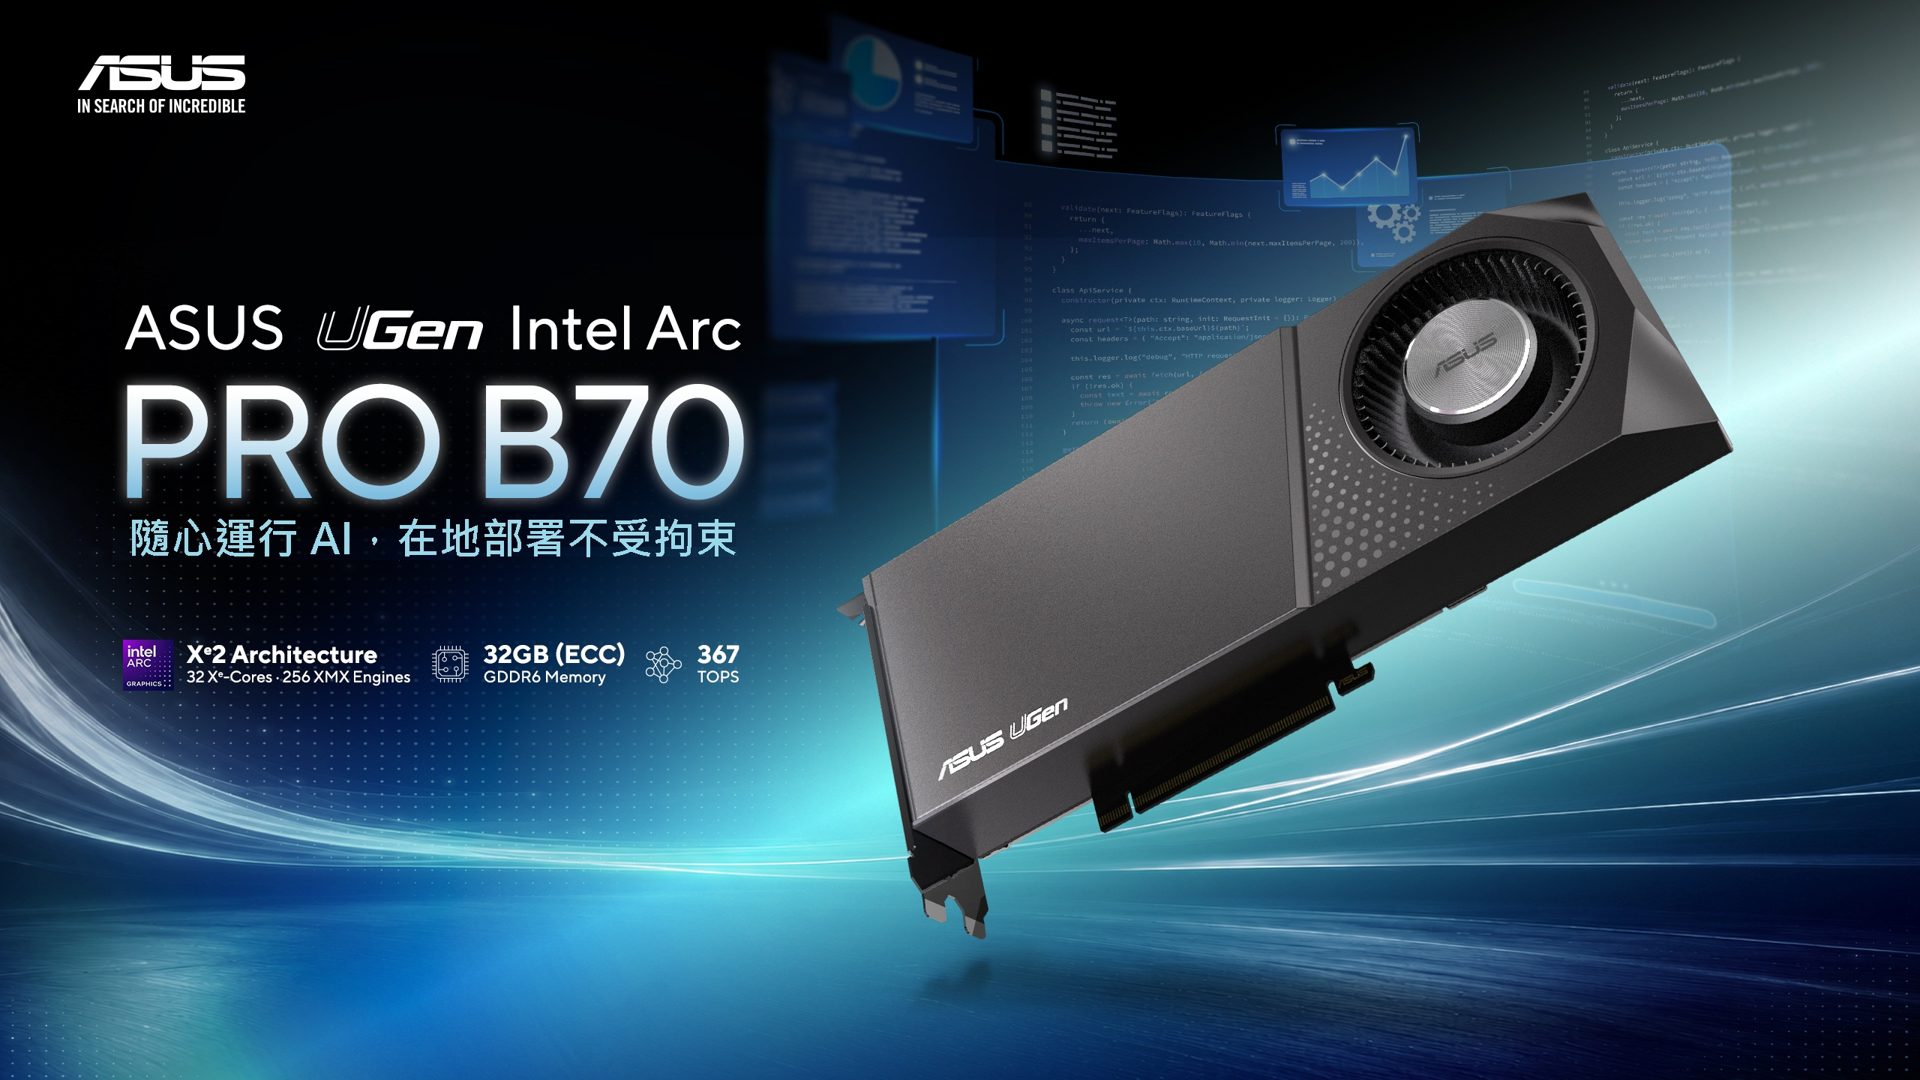 華碩全新UGen Intel® Arc™ Pro B70 32GB推論加速卡,以親民實惠價格提供32GB GDDR6 ECC超大容量記憶體,再加上專為推論優化的硬體架構,是企業執行本地端代理式AI(Agentic AI)時不容錯過的選擇。
突破 VRAM 瓶頸 AI 推理超可以!
現代 AI 工作非常消耗記憶體,例如:較長的上下文推理會大幅增加 KV 快取用量,以及多代理部署,也需要同時執行多個模型,佔用 VRAM;一旦容量不足,資料便會卸載至主記憶體,推論效能可能下降超過 10 倍。全新 ASUS UGen B70 內建 32GB、具 ECC 保護的 GDDR6 記憶體,可支援多數 27B 參數以下的模型,將其完整保留於加速卡上,此外,搭配 Llama 3.1 8B,還能實現高達 128K token 的上下文視窗,並透過雙卡 64GB 或多卡 128GB 擴充,滿足企業 AI 部署所需。
成熟且可立即部署的軟體生態系
內建 INT4 / FP8 線上量化功能的 ASUS UGen B70,擁有完整且成熟的 AI 軟體堆疊支援,包括:Intel LLM Scaler/vLLM XPU、llama.cpp (SYCL/Vulkan)、Ollama、Intel OpenVINO/oneAPI、PyTorch XPU 和用於影像生成的 ComfyUI;經過驗證的模型則涵蓋:Llama 3.1/3.2(8B–70B)、Qwen 3.x、DeepSeek-R1 Distill(7B–70B)、Mistral/Mixtral、OpenAI gpt-oss(20B/120B)、Whisper-large-v3 與 InternVL3.5,且雙卡配置還可以每秒 43.4 token 的流暢速度執行 80B 等級模型,震撼效能無出其右!
為不同規模 AI 導入而生!
全新 ASUS UGen B70 鎖定三大使用者族群—專業消費者、獨立 AI 開發者:單張 32GB 即突破主流 16GB AI 加速卡於大型模型資源上限;小型企業與創意工作室:雙卡 64GB 配置,可在支援更大規模部署時,將敏感資料保留於企業內部;企業部門級 AI 團隊:多卡 128GB 系統,降低長期成本,並符合法律、醫療、政府與金融等領域的資料合規要求。
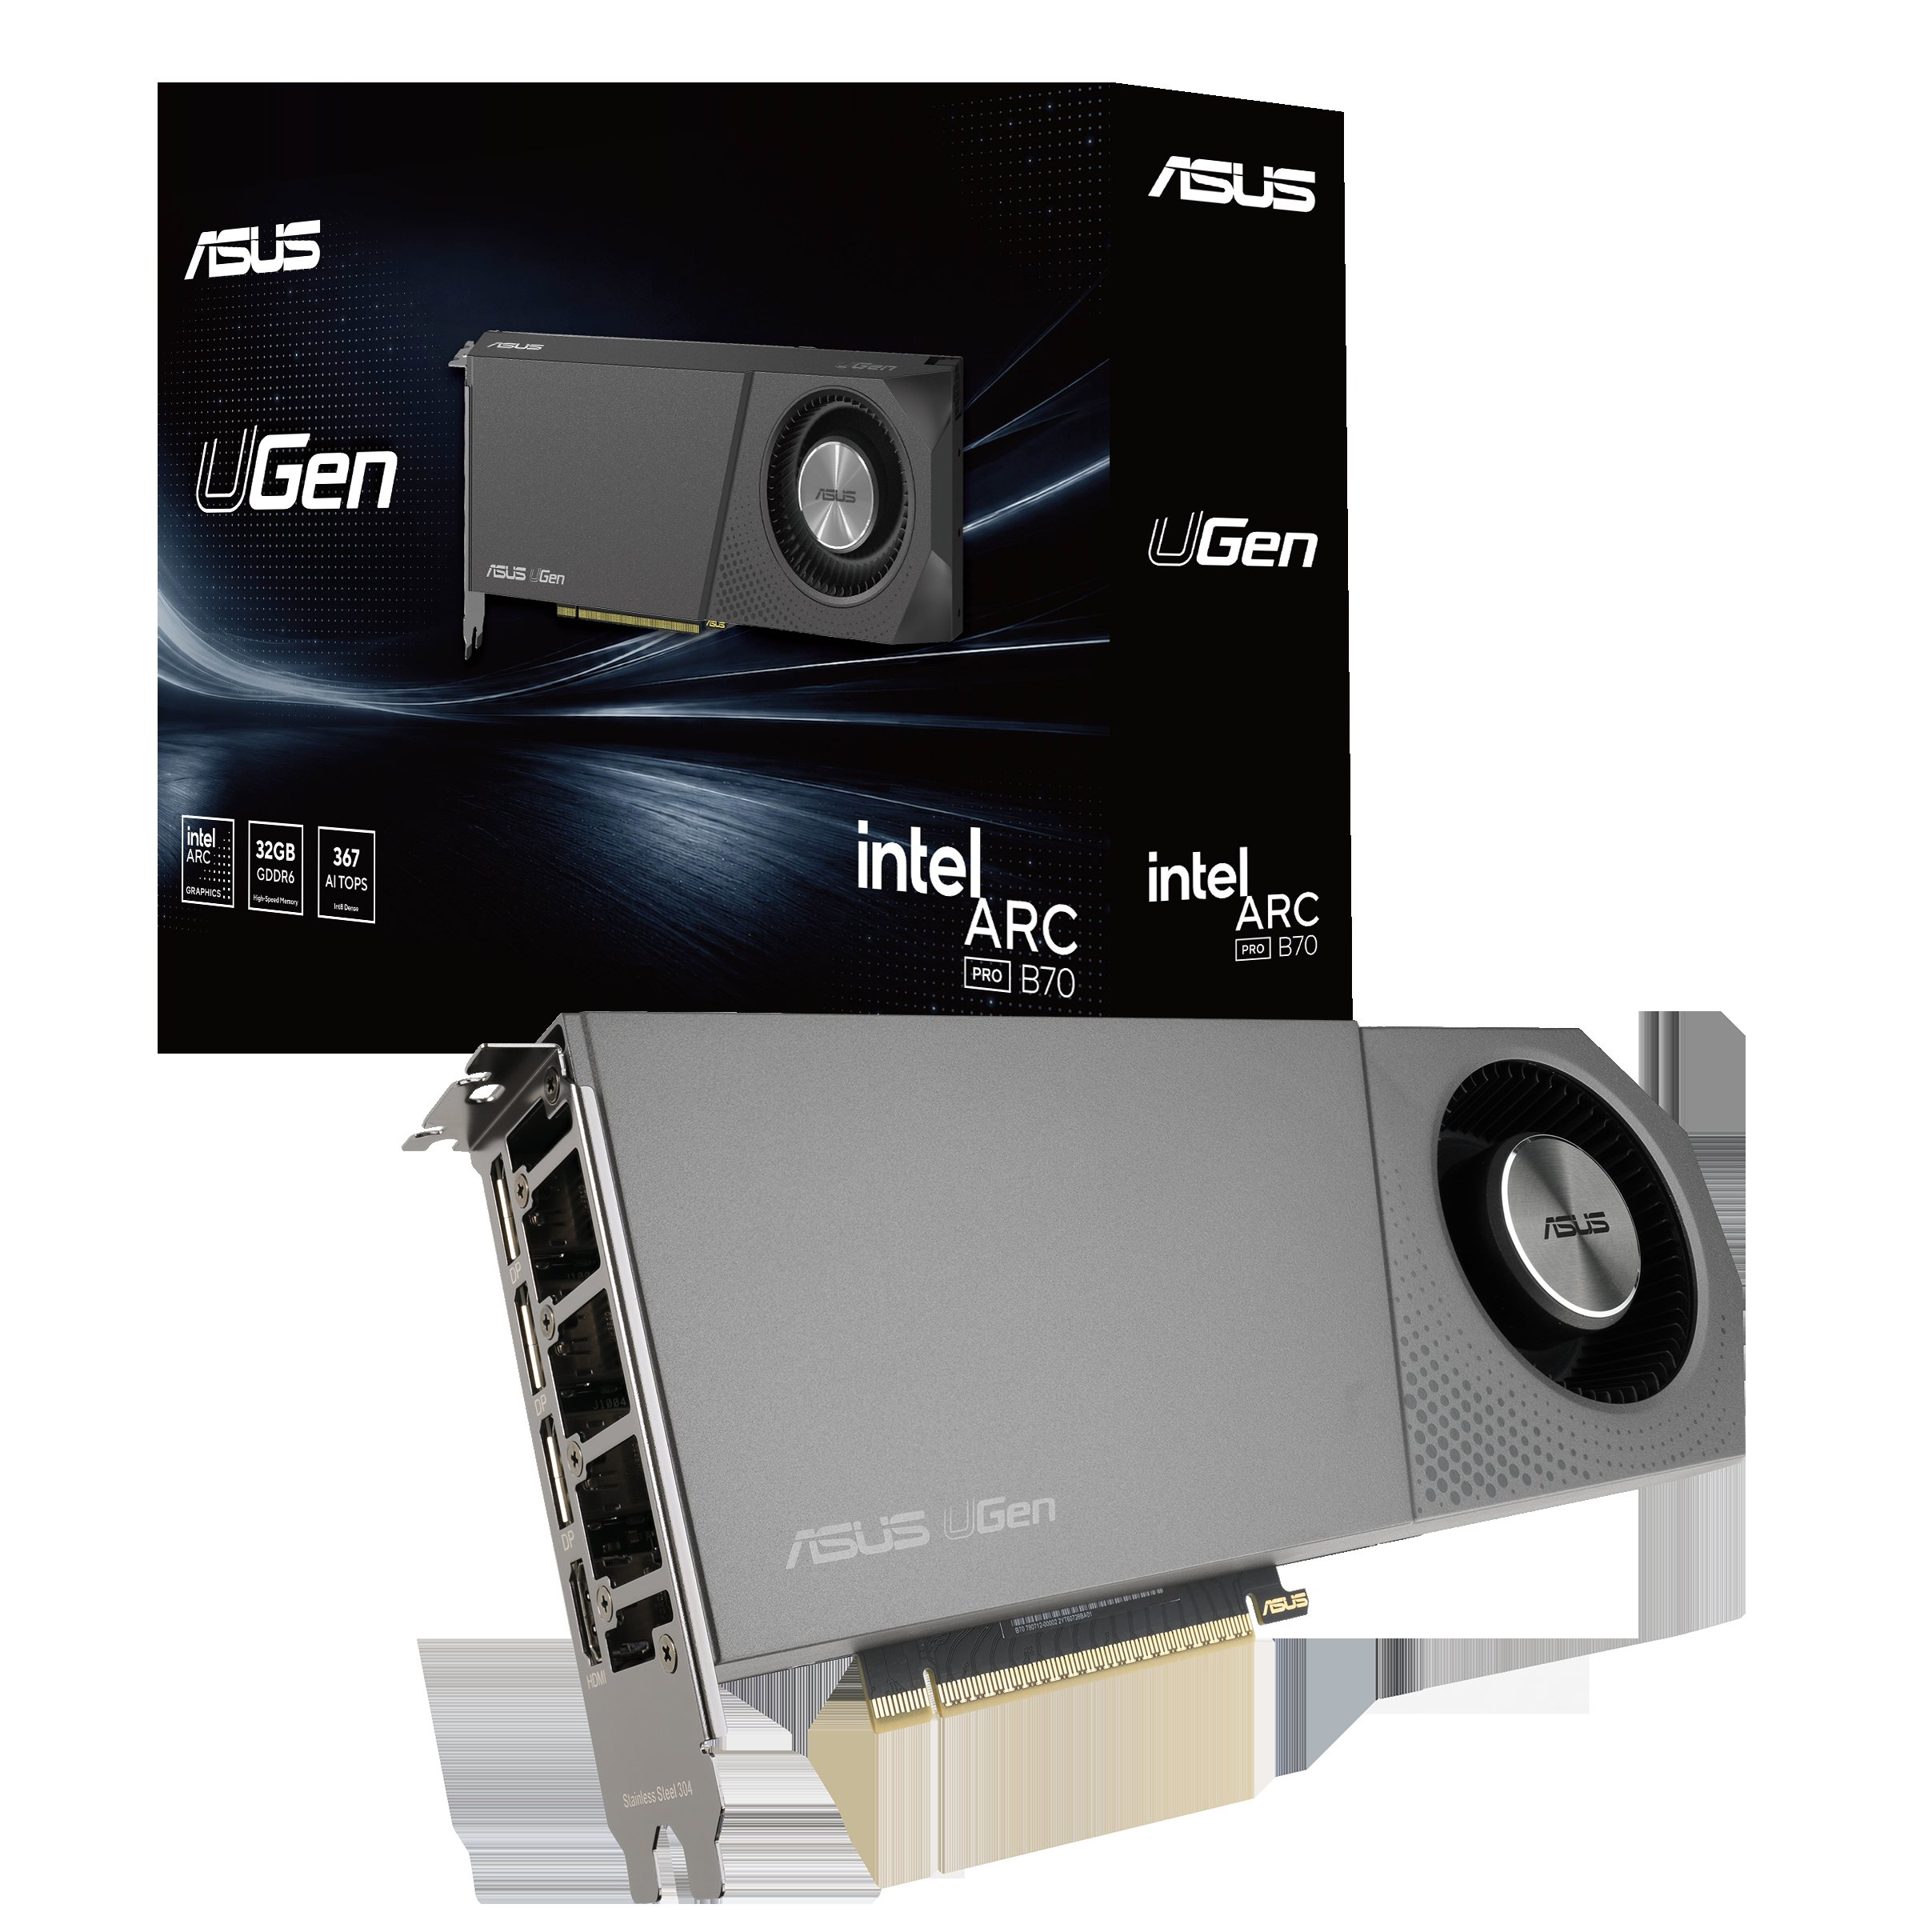 全新ASUS UGen B70搭載32GB VRAM且功耗僅310W,對於AI使用頻率高的個人開發者或組織而言,本地端部署具備更好的投資報酬率。